Ray
1
在法兰克福(Frankfurt)这个全球顶级的互联网枢纽中,Equinix FR7 处于“第一梯队(Tier 1)”和“金牌标准” 的水平。
对于你这样有网络工程背景的用户来说,服务商强调 FR7 通常意味着他们不仅是在德国托管,而且是在整个欧洲互联互通的最核心节点上。以下是 FR7 网络质量的深度拆解:
1. 欧洲互联网的心脏:互联密度
FR7 位于法兰克福 Gutleutstrasse,属于 Equinix 在该地区的“超级Campus”的一部分。
- DE-CIX 接入:FR7 拥有指向 DE-CIX(全球流量最大的交换中心之一)的直接物理连接。物理距离极短意味着极低的抖动(Jitter)和几乎可以忽略不计的内网延迟。
- 运营商密度:该数据中心内有超过 800 家 公司入驻,包括数百个 Tier 1 和 Tier 2 运营商。这意味着在 BGP 选路上,服务商拥有极其丰富的 Peering 选项,可以实现通往西欧、东欧乃至北欧的最优路径。
2. 延迟与性能表现
- 全欧辐射:从 FR7 出发,通往伦敦、阿姆斯特丹、巴黎等核心枢纽的延迟通常在 5-10ms 以内。
- 中欧桥头堡:由于其地理位置,FR7 也是连接西欧与东欧(如波兰、捷克)的枢纽。如果你需要兼顾欧洲全境的访问速度,FR7 的综合路由质量通常优于巴黎或伦敦。
- 金融级可靠性:FR7 历史上重点服务于金融服务行业,这意味着其物理网络架构(如 Meet-Me Rooms 和光纤路由冗余)是按照极高的 SLA 标准设计的。
3. 为什么服务商要“突出”它?
如果一个服务商(特别是 VPS 或裸金属供应商)强调 FR7,主要是在展示以下资产:
- 非廉价机房:法兰克福有很多偏远的二线机房(延迟和稳定性稍差但价格极低),而 FR7 的机架位和带宽成本较高,属于溢价机位。
- 优质上游(Upstreams):在 FR7 内部,服务商可以非常容易地接入类似 Deutsche Telekom (DTAG)、Telia、GTT、Liberty Global 等顶级线路。(注:对于中国用户,DTAG 的对华路由在某些时期表现较好,但仍需看具体服务商的 Peer 策略。)
- Equinix Fabric:支持通过软件定义网络(SDN)直接私有连接到 AWS、Azure、Google Cloud 等云服务商的 On-ramp 节点,延迟最低可达亚毫秒级。
4. 给网络工程师的避坑提示
虽然 FR7 是顶级机房,但最终的网络质量还取决于服务商的“内功”:
- BGP 策略:如果服务商在 FR7 只有单一上游,或者为了省钱只走低成本的交换中心(IXP)而不买高成本的 IP Transit(如 DTAG 或 PCCW),那么即是在 FR7,高峰期的丢包率也可能很难看。
- 中国方向路由:对于国内访问,法兰克福直连通常走 AS4809 (CN2 GIA) 或 AS9929。如果服务商没有专门拉这些线路,流量通常会绕行美国或经过极其拥堵的 AS4134 (163 骨干网),这时候 FR7 的“地段优势”对中国用户就没那么明显了。
总结
Equinix FR7 的水平相当于数据中心界的“五星级酒店”。如果你的业务侧重于欧洲本土低延迟、金融级高可用或者作为欧洲骨干网的核心节点,FR7 是法兰克福乃至全欧洲能选到的最佳位置之一。
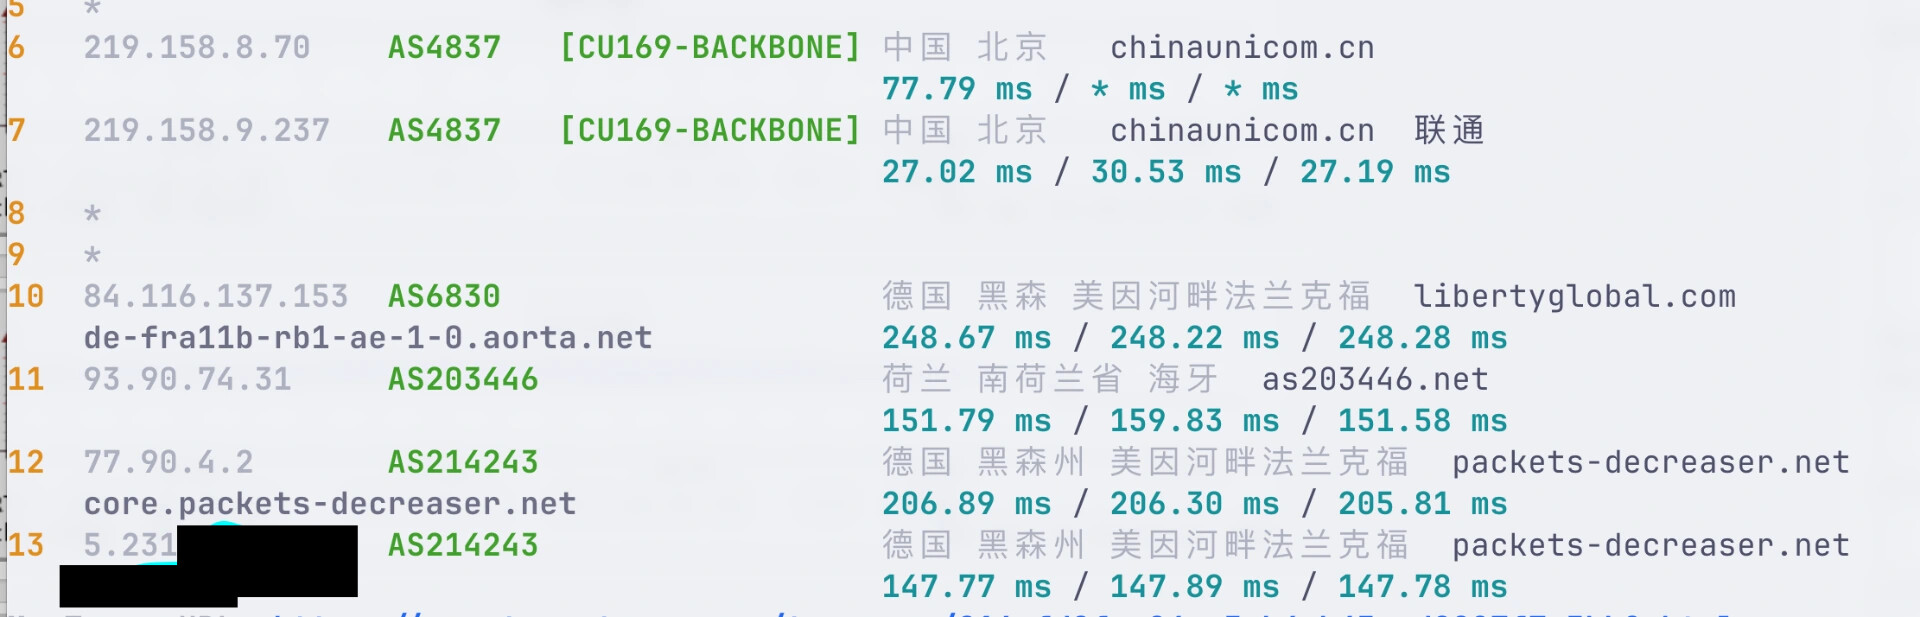
关于线路:
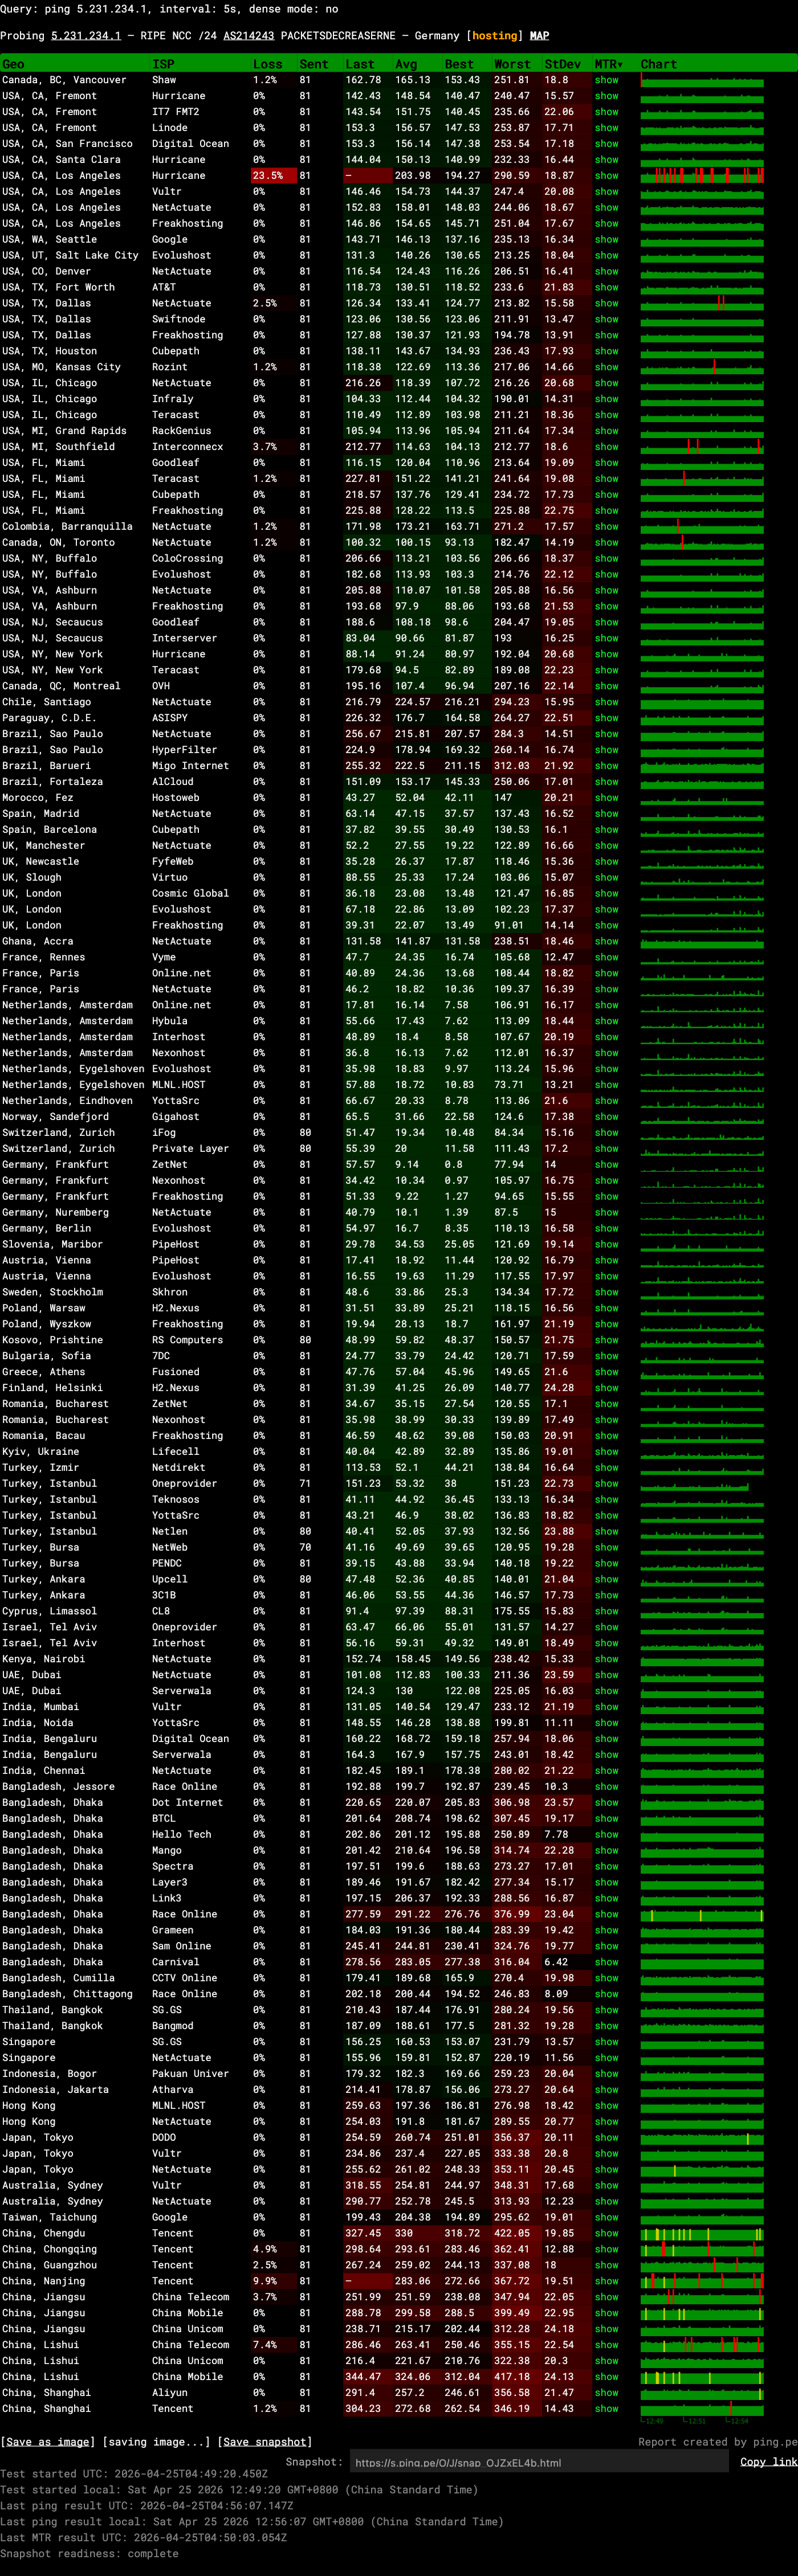
线路如果不经过清洗就很低,实际测试延迟低于150ms
1. 核心 Peer 线路识别
-
AS6830 (Liberty Global / Aorta)
- 身份:欧洲最大的宽带运营商之一(旗下拥有 Virgin Media, Unitymedia 等)。
- 评价:它是法兰克福最重要的 Tier-1 级 运营商之一。联通 AS4837 在法兰克福与它有大量的 Peering。
- 特征:
aorta.net 是 Liberty Global 的核心骨干网名称。这代表你的流量从联通出来后,直接进入了欧洲最稳健的“毛细血管”网络。
-
AS203446 (Smartnet / Smart-Net)
- 身份:这通常是 Anexia 或其关联的 Smart-Net 网络。
- 评价:这是一个高性能的 IP Transit 和专网提供商。
- 技术细节:主机名中的
rt-qfx10k-fkt 表明它使用了 Juniper QFX10000 系列 交换机(这是顶级的数据中心级设备)。smartnet.network 通常出现在追求低延迟和高质量路由的 BGP 组合中。
-
AS214243 (Packets-Decreaser / Combahton)
- 身份:这是德国著名的 Combahton 防御网络的改名或子品牌。
- 评价:这是这跳路由的精髓。
Packets-Decreaser 顾名思义是专门做流量清洗和 DDoS 防护的。
- 特征:如果你看到这个 AS,说明你选择的服务商(可能是 Netcup 的某些高级线路、V.PS 或者专门的德国高防机房)在法兰克福部署了 Combahton 防护。
2. 网络质量评价:处于什么水平?
从这份路由来看,你的线路具有以下特点:
优点:
- 防御力极强:流量经过了
Packets-Decreaser (Combahton),这意味着该线路天生自带高强的 DDoS 清洗能力。对于你这种管理多个 VPS 和 PVE 集群的管理员来说,这提供了极佳的安全性。
- 设备精良:跳数中出现的 Juniper QFX 系列设备意味着中间节点的吞吐能力和转发延迟非常优秀。
- 大厂 Peer:直接与 Liberty Global (Aorta) 交汇,保证了其在欧洲境内的访问速度(通常到全欧都在 20ms 以内)。
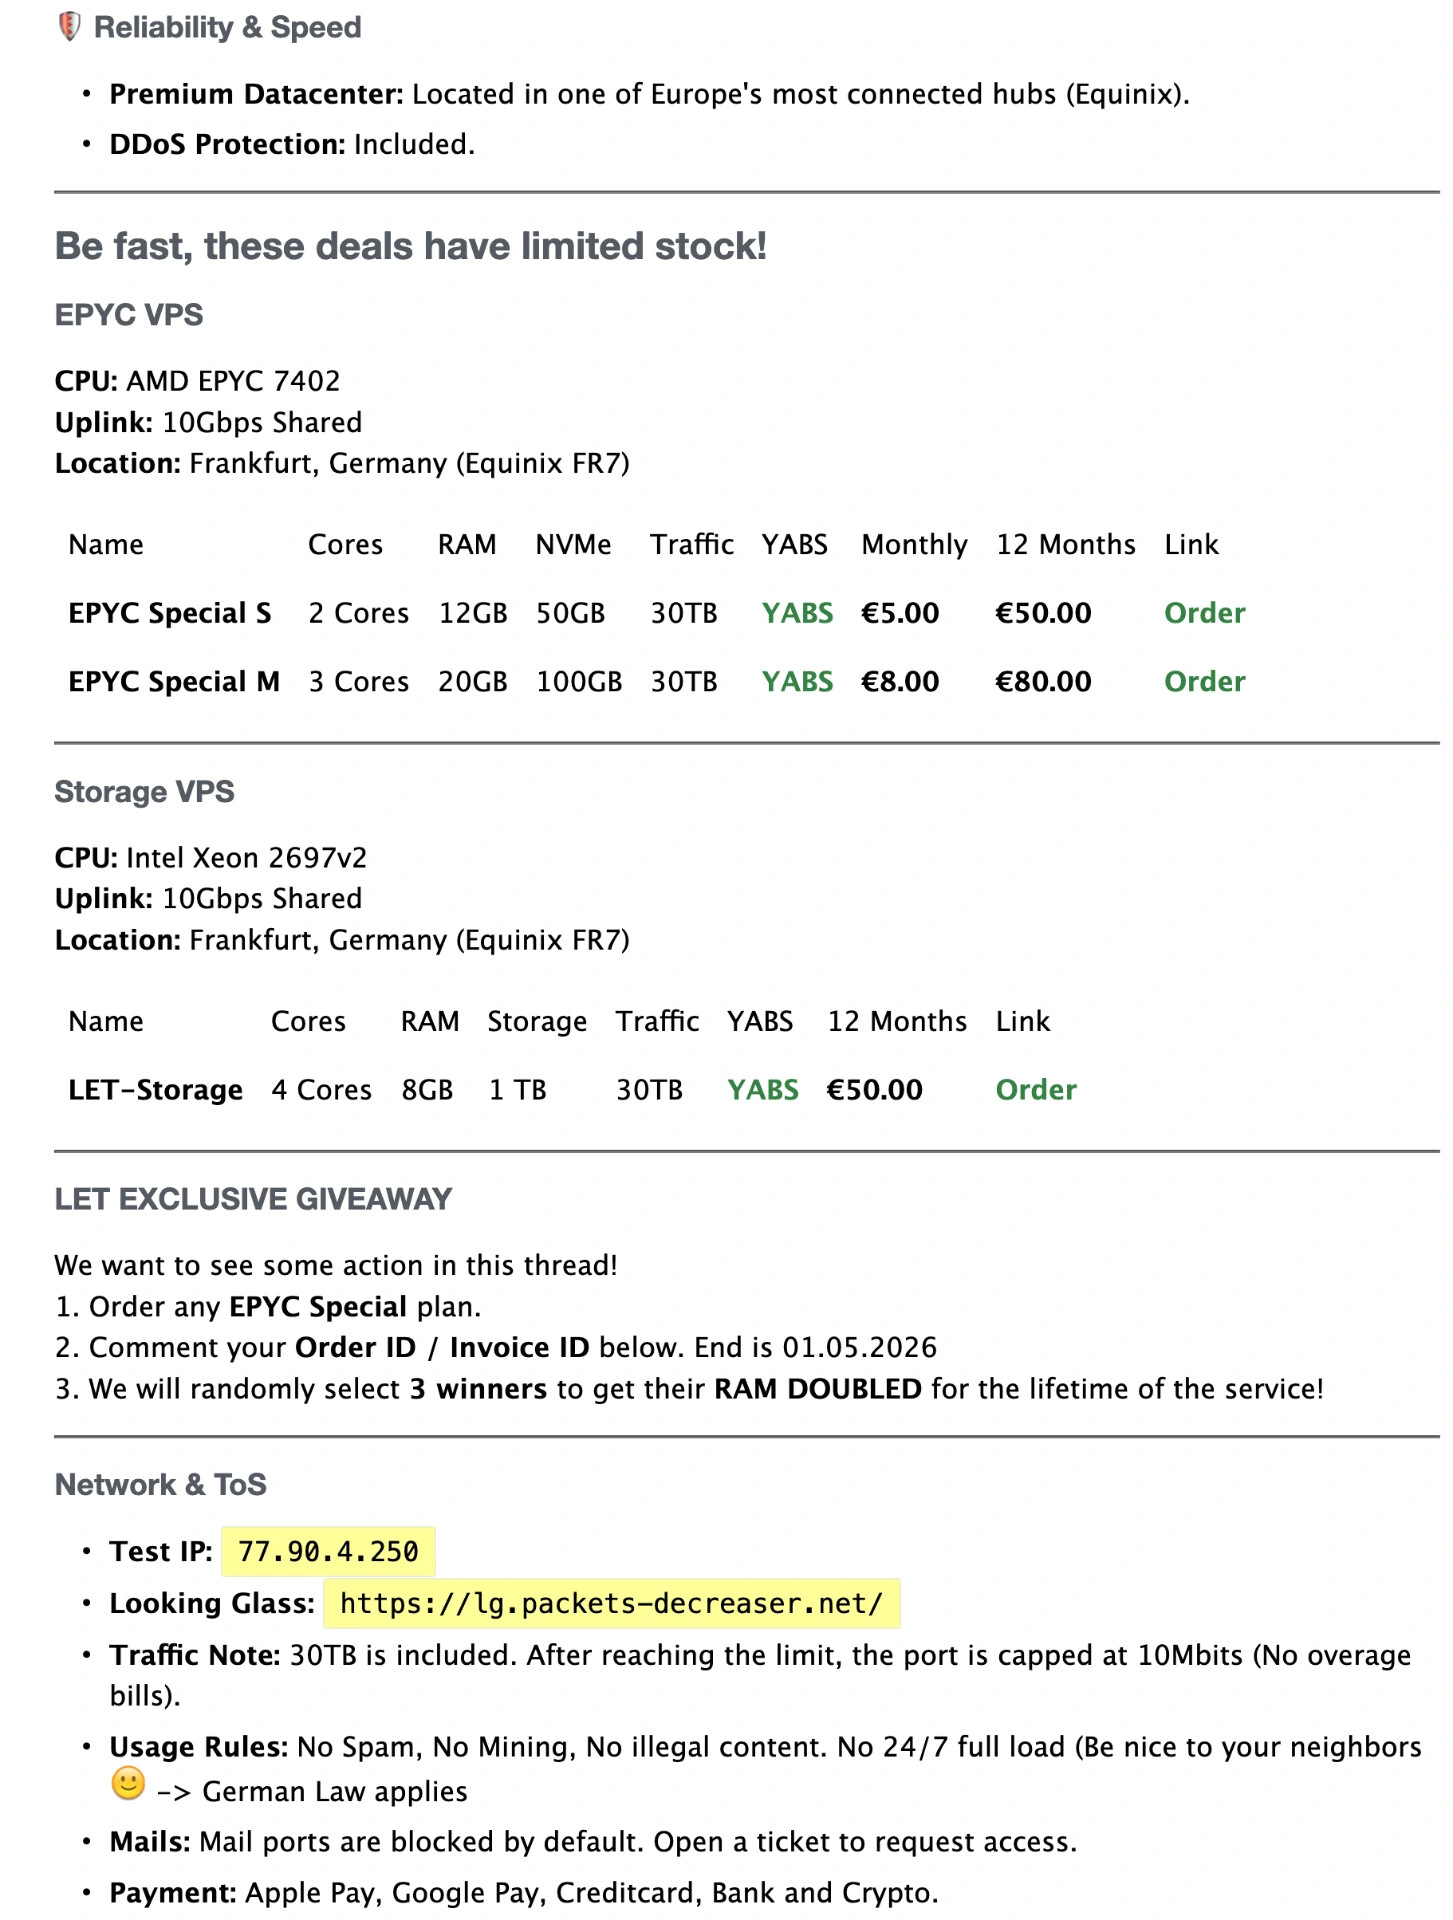
机房优秀,欧洲中心节点。看了下路由,非常稳, tier1。开机后看IP居然有惊喜 延迟150ms以内。加了个50G硬盘, 0.75欧
EYPC 7402P 30TB流量 超出后限速10M不计费
| Name |
Cores |
RAM |
NVMe |
Traffic |
YABS |
Monthly |
12 Months |
| EPYC Special S |
2 Cores |
12GB |
50GB |
30TB |
YABS |
€5.00 |
€50.00 |
| EPYC Special M |
3 Cores |
20GB |
100GB |
30TB |
YABS |
€8.00 |
€80.00 |
Storage VPS
配置详情:
- CPU: Intel Xeon 2697v2
- Uplink: 10Gbps Shared
- Location: Frankfurt, Germany (Equinix FR7)
| Name |
Cores |
RAM |
Storage |
Traffic |
YABS |
12 Months |
| LET-Storage |
4 Cores |
8GB |
1 TB |
30TB |
YABS |
€50.00 |
| 无aff下单链接 |
敬请AFF先注册 |
|
|
|
|
|
| 详情见原帖:LINK |
|
|
|
|
|
|
Test IP: 77.90.4.250
Looking Glass: https://lg.packets-decreaser.net/
Ray
2
顶级的线路 非常棒!使用下面的sysctl后的结果:
优秀的线路质量上海-法兰克福
iperf3 theIP -u -b 100M
[ ID] Interval           Transfer     Bitrate         Total Datagrams
[  5]   0.00-1.00   sec  11.9 MBytes   100 Mbits/sec  8930
[  5]   1.00-2.00   sec  11.9 MBytes   100 Mbits/sec  8929
[  5]   2.00-3.00   sec  11.9 MBytes   100 Mbits/sec  8928
[  5]   3.00-4.00   sec  11.9 MBytes   100 Mbits/sec  8928
[  5]   4.00-5.00   sec  11.9 MBytes   100 Mbits/sec  8930
[  5]   5.00-6.00   sec  11.9 MBytes   100 Mbits/sec  8936
[  5]   6.00-7.00   sec  11.9 MBytes   100 Mbits/sec  8920
[  5]   7.00-8.00   sec  11.9 MBytes   100 Mbits/sec  8929
[  5]   8.00-9.00   sec  11.9 MBytes   100 Mbits/sec  8928
[  5]   9.00-10.00  sec  11.9 MBytes   100 Mbits/sec  8929
[  5]  10.00-10.26  sec  3.11 MBytes   100 Mbits/sec  2328
- - - - - - - - - - - - - - - - - - - - - - - - -
[ ID] Interval           Transfer     Bitrate         Jitter    Lost/Total Datagrams
[  5]   0.00-10.26  sec   122 MBytes   100 Mbits/sec  0.000 ms  0/91615 (0%)  sender
| 指标 |
优化前 (30s) |
优化后 (30s) |
评价 |
| 总传输数据 (Transfer) |
733 MBytes |
940 MBytes |
提升约 28%。在同样的带宽环境下,有效载荷大幅增加。 |
| 平均位速率 (Bitrate) |
204 Mbits/sec |
262 Mbits/sec |
跑得更满了,非常接近法兰克福到国内 4837 的公网极限。 |
| 末端稳定性 (29-30s Retr) |
较高且波动 |
331 (SUM) |
巨大进步。开头 1-2 秒仍在探测,但最后 1 秒重传极低。 |
附上调优后的sysctl。新建/etc/sysctl.d/99-bbr-RAM.conf 复制以下内容。运行 sysctl -p --system 生效
# ===============================================================
# 系统性能与网络深度优化配置 (针对 12GB RAM / 高延迟高防护路径)
# ===============================================================

# --- 1. 虚拟内存 (VM) 优化 ---
# 减少交换频率,优先使用物理内存 (12GB 内存建议设为 10)
vm.swappiness = 10
# 保持更多的 VFS 缓存(对文件系统如 Seafile/Nextcloud 友好)
vm.vfs_cache_pressure = 50
# 增加内存映射区域的最大数量 (对数据库、Elasticsearch 必选)
vm.max_map_count = 262144
# 允许应用分配超过物理内存的内存
vm.overcommit_memory = 1

# --- 2. 文件系统优化 ---
# 提高最大文件句柄数
fs.file-max = 2097152
# 提高进程最大监听队列
fs.nr_open = 2097152
# 允许进程倾倒 core 文件(按需,默认可保持)
# fs.suid_dumpable = 0

# --- 3. 核心网络栈基础优化 ---
# 增加网络接口接收队列
net.core.netdev_max_backlog = 32768
# 增加最大并发连接数 (SOMAXCONN)
net.core.somaxconn = 16384
# 增加接收/发送缓冲区最大值 (64MB,应对 200ms 延迟)
net.core.rmem_max = 67108864
net.core.wmem_max = 67108864
net.core.optmem_max = 65536

# --- 4. IPv4 网络协议栈专项优化 ---
# 开启 BBR + FQ
net.core.default_qdisc = fq
net.ipv4.tcp_congestion_control = bbr

# TCP 读写缓冲区自动调优 (min, default, max)
# 针对高带宽时延乘积 (BDP),max 设为 64MB
net.ipv4.tcp_rmem = 4096 87380 67108864
net.ipv4.tcp_wmem = 4096 65536 67108864

# 开启并优化 SACK (对高重传环境至关重要)
net.ipv4.tcp_sack = 1
net.ipv4.tcp_dsack = 1
net.ipv4.tcp_fack = 1

# 禁用空闲后的慢启动 (防止流量波动后的速度归零)
net.ipv4.tcp_slow_start_after_idle = 0

# 平滑发包增益 (防止 BBR 过于激进触发 Combahton 限速)
net.ipv4.tcp_pacing_ss_ratio = 120
net.ipv4.tcp_pacing_ca_ratio = 110

# 允许更小的探测周期
net.ipv4.tcp_notsent_lowat = 16384

# 开启 MTU 探测 (应对长途路径上的 MTU 黑洞)
net.ipv4.tcp_mtu_probing = 1

# 开启 TCP Fast Open (减少握手往返延迟)
net.ipv4.tcp_fastopen = 3

# TIME-WAIT 状态重用
net.ipv4.tcp_tw_reuse = 1
net.ipv4.tcp_max_tw_buckets = 262144

# 提高半连接队列长度
net.ipv4.tcp_max_syn_backlog = 16384
# 减少断开连接时的 FIN-WAIT-2 存活时间
net.ipv4.tcp_fin_timeout = 20

# 开启 ECN 拥塞通知
net.ipv4.tcp_ecn = 1

# --- 5. IPv6 优化 (针对你之前的 SDN/IPv6 实验) ---
net.ipv6.conf.all.disable_ipv6 = 0
net.ipv6.conf.default.disable_ipv6 = 0
net.ipv6.conf.all.forwarding = 1
# 增加邻居表大小 (防止邻居表满导致的 IPv6 FAILED 状态)
net.ipv6.neigh.default.gc_thresh1 = 1024
net.ipv6.neigh.default.gc_thresh2 = 2048
net.ipv6.neigh.default.gc_thresh3 = 4096

# --- 6. 内核安全增强 (防 ICMP 泛洪等) ---
net.ipv4.conf.all.accept_source_route = 0
net.ipv4.conf.default.accept_source_route = 0
net.ipv4.icmp_echo_ignore_broadcasts = 1
net.ipv4.icmp_ignore_bogus_error_responses = 1
Ray
3
Basic System Information:
---------------------------------
Uptime     : 0 days, 4 hours, 53 minutes
Processor  : AMD EPYC 7402P 24-Core Processor
CPU cores  : 2 @ 2800.000 MHz
AES-NI     : ✔ Enabled
VM-x/AMD-V : ✔ Enabled
RAM        : 11.7 GiB
Swap       : 0.0 KiB
Disk       : 98.3 GiB
Distro     : Debian GNU/Linux 13 (trixie)
Kernel     : 6.12.74+deb13+1-amd64
VM Type    : KVM
IPv4/IPv6  : ✔ Online / ✔ Online
IPv6 Network Information:
---------------------------------
ISP        : Marc Fischer
ASN        : AS214243 Marc Fischer
Host       : PacketsDecreaser
Location   : Frankfurt am Main, Hesse (HE)
Country    : Germany
fio Disk Speed Tests (Mixed R/W 50/50) (Partition /dev/sda1):
---------------------------------
Block Size | 4k            (IOPS) | 64k           (IOPS)
  ------   | ---            ----  | ----           ----
Read       | 269.51 MB/s  (67.3k) | 2.51 GB/s    (39.2k)
Write      | 270.22 MB/s  (67.5k) | 2.52 GB/s    (39.4k)
Total      | 539.73 MB/s (134.9k) | 5.03 GB/s    (78.6k)
           |                      |
Block Size | 512k          (IOPS) | 1m            (IOPS)
  ------   | ---            ----  | ----           ----
Read       | 950.17 MB/s   (1.8k) | 2.08 GB/s     (2.0k)
Write      | 1.00 GB/s     (1.9k) | 2.22 GB/s     (2.1k)
Total      | 1.95 GB/s     (3.8k) | 4.31 GB/s     (4.2k)
测速会遇到网络限制,但在使用中这不是问题。
Geekbench 5 Benchmark Test:
---------------------------------
Test            | Value
                |
Single Core     | 1043
Multi Core      | 2047
iperf3 Network Speed Tests (IPv4):
---------------------------------
Provider        | Location (Link)           | Send Speed      | Recv Speed      | Ping
-----           | -----                     | ----            | ----            | ----
Clouvider       | London, UK (10G)          | 6.84 Gbits/sec  | 4.81 Gbits/sec  | 11.6 ms
Ray
4
SSH 断连是一个非常典型的**“小马拉大车”**现象。看到你 6.84 Gbits/sec 的测速结果,我既为你这台机器的带宽感到惊喜,也为你的 CPU 捏了一把汗。
简单直接的结论是:这不是服务商在针对你,也不是设置错误,而是你的 CPU 暂时“罢工”了。
1. 深度分析:为什么会断连?
你的 YABS 结果显示,往伦敦方向跑到了 6.84 Gbps。对于一个单核 Geekbench 分只有 1000 的 2 核 CPU 来说,处理这个量级的流量压力是巨大的:
- CPU 饱和 (CPU Starvation):
处理 7Gbps 的 TCP 流量需要内核进行海量的中断处理(Softirq)和数据包封装。由于你只有 2 个核心,当 iperf3 把这两个核心全部占满去处理网络包时,负责维持 SSH 连接的 sshd 进程拿不到 CPU 时间片,无法及时回复 Keep-alive 心跳包,于是 SSH 客户端认为服务器掉线了。
- 中断风暴 (Interrupt Storm):
在 10Gbps 级别的高速传输中,网卡会产生极高频的中断。如果 CPU 性能较弱,它会陷入“不停地处理网络中断,却没空处理用户指令”的死循环。
- 缓冲区延迟 (Bufferbloat):
咱们之前为了优化跨境长肥管道,把 net.core.rmem_max 等缓冲区设到了 64MB。在跑 7Gbps 这种极速测试时,如果缓冲区被塞满而 CPU 来不及处理,会产生巨大的排队延迟,导致 SSH 这种对实时性要求极高的流量被“憋死”在队列里。
2. 这证明了什么?
这个现象反而为你提供了两个非常有价值的信息:
- 你的 10Gbps 端口是真材实料:能跑到 6.8Gbps 说明服务商在 Equinix FR7 的内网交换能力极强,物理链路没有任何水分。
- 验证了 CPU 是你唯一的短板:这台机器的带宽上限远高于它的 CPU 处理上限。
3. 如何解决和规避?
如果你想完整跑完测试而不掉线,可以尝试以下方法:
工程师的最终评价
别担心,你的机器没问题。 这就好比你给一台老款甲壳虫装了一个波音 747 的引擎:当你把油门踩到底(测速)时,车架子(CPU)会因为跟不上引擎的转速而剧烈抖动甚至散架,但引擎本身是极其强大的。
在实际使用中(比如跑 Discourse 或 Proxmox 节点),你很难遇到这种瞬间消耗 7Gbps 带宽的场景,所以平时的 SSH 是很稳的。
Ray
5
很有趣,对国内这些ping point 延迟显得很高 实际到上海我这里是148ms。线路清洗作用?
Ray
6
给~/.ssh/config加入:
Host *
	ServerAliveInterval 60
	ServerAliveCountMax 10
只使用一个vCore的命令:taskset -c 0 ./yabs.sh -s -- -g -f -r
//跳过benchmark;跳过fio;减少网络测速点
iperf3 Network Speed Tests (IPv4):
---------------------------------
Provider        | Location (Link)           | Send Speed      | Recv Speed      | Ping
-----           | -----                     | ----            | ----            | ----
Clouvider       | London, UK (10G)          | 6.95 Gbits/sec  | 2.00 Gbits/sec  | 11.5 ms
Leaseweb        | Singapore, SG (10G)       | 2.89 Gbits/sec  | 3.77 Gbits/sec  | 161 ms
Leaseweb        | NYC, NY, US (10G)         | 4.84 Gbits/sec  | 3.84 Gbits/sec  | 94.5 ms

iperf3 Network Speed Tests (IPv6):
---------------------------------
Provider        | Location (Link)           | Send Speed      | Recv Speed      | Ping
-----           | -----                     | ----            | ----            | ----
Clouvider       | London, UK (10G)          | 6.79 Gbits/sec  | 4.76 Gbits/sec  | 11.5 ms
Leaseweb        | Singapore, SG (10G)       | 2.72 Gbits/sec  | 5.70 Gbits/sec  | 161 ms
Leaseweb        | NYC, NY, US (10G)         | 5.74 Gbits/sec  | 6.21 Gbits/sec  | 84.3 ms

YABS completed in 2 min 50 sec